你随手安装的那些 skill,会消耗你多少 token
TL;DR 只加载 1 个 skill,420 万 token 照扣不误;skill 不该靠「装」来管理,该靠「投放」。
先说结论:skill 的消耗不在于你「用」了多少,而在于你「装」了多少。装进去的那一刻,账单就开始计时了。
这话不是我拍脑袋说的。前几天跑完一个长任务,顺手翻了下 agent 的 token 统计面板,几个数字摆在一起,看得我有点沉默。
一次实测:只加载了 1 个 skill,账单长这样
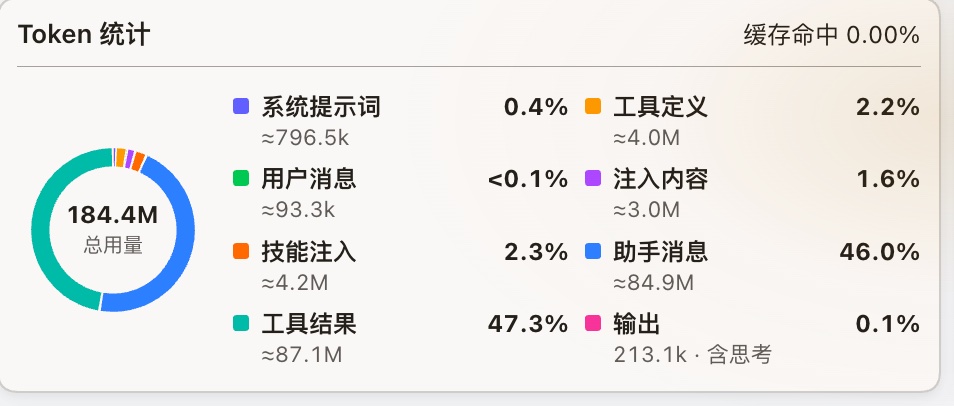
先看任务整体的账。这个任务跑下来,总用量 184.4M token,1.84 亿。其中工具结果 87.1M(47.3%)、助手消息 84.9M(46.0%),这两块是大头,符合直觉:长任务嘛,工具来回调、模型来回写,钱主要花在这儿。
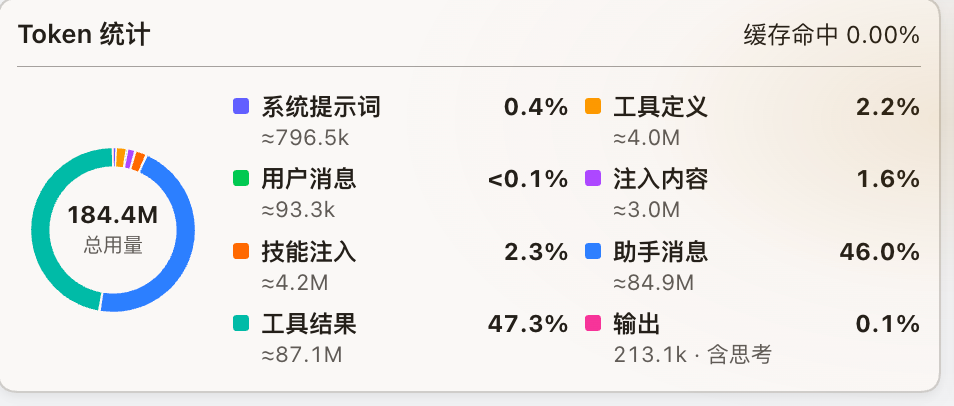
然后看 skill 相关的那一行:技能注入(累计)约 4.2M,占 2.3%。
4.2M 是什么概念?放在 1.84 亿里是 2.3%,确实是「说少不少,说多也不多」。但先别下结论,看看这 4.2M 是由什么叠出来的。
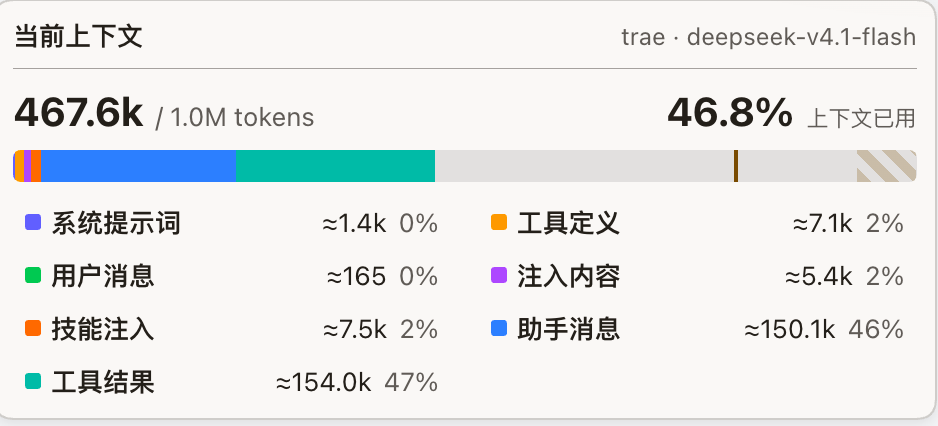
任务结束时,当前上下文 467.6k / 1.0M,用了 46.8%。里面技能注入约 7.5k,占 2%。注意,这 7.5k 是单轮快照,每一轮都在。累计的 4.2M,就是这种东西乘以五六百轮叠出来的。
那这单轮 7.5k 里装的是什么?展开看:
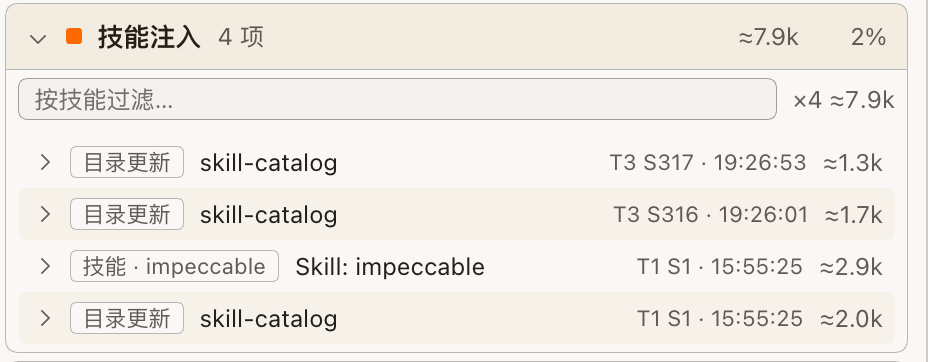
4 项注入里,3 项是 skill-catalog 的目录更新(1.3k、1.7k、2.0k),只有 1 项是真正加载技能正文:Skill: impeccable,2.9k。
把前提摆清楚:这个环境里安装了不到 20 个 skill,整个任务全程只加载了 1 个。 就 1 个。剩下的消耗全花在「目录」上:agent 要把「我有哪些 skill 可用」这份清单带在上下文里,装得越多,清单越长,固定开销越大。说白了,你用一个 skill,付一份钱;你装二十个 skill 只用一个,付的是二十个的目录钱,再乘以轮数。
外推一下:无限制安装会怎样
把账算明白只需要小学乘法。
目录里每个 skill 占一行名字加描述,粗算 50–100 token。20 个 skill 的目录约 1–2k token,和我实测里一次目录更新的体积(1.3k–2.0k)对得上。那如果像很多人一样,随手就装几个skill,装到一两百个呢?目录本身一轮就是 10k–20k token,雷打不动;一个任务跑几十轮,几十万到上百万 token 纯交给目录。
token 账单还是小事。真正贵的是另一笔:候选清单越长,模型挑错 skill、或者干脆漏掉正确 skill 的概率越高。就像在一箱别人的工具里翻自己的扳手,工具越多,翻错的那次越致命。skill 本来是来省 token、省口水的,装多了反而变成每轮必缴的税。
所以别纠结「skill 有没有用」了,真正的问题是「安装」这个动作本身太粗糙。npx 一条命令全量推给所有 agent,爽是真爽,账也是真账。我想要一种极其简单的方式,对 skill 做精细化管理:平时收在库里,哪个 agent、哪个项目需要,再投哪几个过去。
flint:把 skill 当资产管,而不是当插件装
这个需求我自己解决了一下,就是 flint(local-skills-hub)。之前写过一篇《Flint:让 skill 成为个人资产》讲它的设计哲学:local-first、数据主权、skill 只是磁盘上的普通文件。这篇不重复那些,只讲它怎么解决「按需开启」这件事。
核心思路一句话:归集一次,投放按需。
归集。所有 skill 的本体只存一份,放在你自己的仓库目录里,就是磁盘上一个普通文件夹,git 想怎么管怎么管。散落在各个 agent 目录里的、从第三方 npx 装来的、从别的目录导入的,flint 都能收进来:同名自动去重,来源分歧在 Health 页列出来一键修。收完之后,agent 目录里不再是各自为政的副本,而是指向仓库的软链。
投放。这是解决 token 问题的关键一步。flint 里有个「预设(Preset)」:一个 skill 包,成员可以是显式指定的几个 skill,也可以是「带某标签的全部」。然后到 agent 详情页,选一个预设,点「Apply preset」,只有这个预设里的 skill 会被部署进该 agent 的 skill 目录。没链接预设的 agent,一个 skill 都看不到,目录注入自然是零。
换句话说,agent 上下文里那份 catalog 清单的长度,从此由你决定:写博客的 agent 只挂写作相关的三五个 skill,目录就只收三五行的税;跑前端任务的 agent 挂 impeccable 那一批,互不干扰。想换组合?改预设成员或标签,再点一次 Apply,完事。
智能体管理。flint 的 Agents 页按「实际 skill 目录」出卡片:多个 agent 共用一个目录就合并成一张卡、共用一套策略,不会给你演出「改了 A 发现 B 没生效」的戏码。每张卡上能做的事:启用或停用、覆盖目录、从库里逐个加 skill、套预设一键部署、单个 skill 选软链还是拷贝。目录里物理上有什么,agent 就看到什么,没有后台偷偷同步的玄学。
这套组合拳打下来,「装了 200 个 skill」和「这个 agent 能用 5 个 skill」就彻底解耦了。库可以无限大,税只按投放的交。
顺便提一嘴:flint 还能干什么
按需投放是主线,但归集和投放这两层搭好之后,剩下的功能基本是顺出来的:
- Projects:给项目登记路径加标签,标签就是部署策略。匹配的 skill 进项目的
.agents/skills(可以跟 git 提交),再软链共享给各 agent 的项目级目录。换机器,项目自带技能包。 - Health:六维体检(同步状态、重复、断链、配置、仓库、项目),问题列出来,一键修之前先让你确认。
- npx 安装托管:把
npx xxx skills install这类命令贴进去,flint 在受管目录里跑(自带 git 快照可回滚),装完直接进正常注册流程;更新就是源卡片上一个按钮。 - 标签与元数据:标签优先写进
SKILL.md的 frontmatter,就是 Claude Code 等 40+ 工具原生能读的那份;没回写的先在本地暂存,一键迁移。
安装就一行:npx flint-skills-hub,然后开 http://localhost:8787。没有云、没有账号、没有遥测,skill 是你磁盘上的文件,flint 卸了它们也在。界面中英可切换,日志可下载,都是顺带的手尾。
回到开头那组数字
1.84 亿 token 的任务,skill 注入累计 4.2M,占 2.3%。单看比例确实不能算多。但别忘了前提:这是个只装了不到 20 个 skill、全程只用了 1 个的环境。
skill 这东西,价值在「复用」,成本在「常驻」。管理方式粗暴一点,成本就常驻给你看。
所以下次手痒想 npx 全量装一套技能包之前,先问自己一句:这二十个 skill,我这个 agent 真用得上几个?
想清楚再装。或者干脆别装:归集进库,按需投放,让目录永远只留真正干活的那几个。
 微信