Flint:让 skill 成为个人资产
最近一段时间,每当 OpenAI 有新模型发布,都会有一种论调:skill 没用了,越来越多用户开始弃用 skill。
这话对吗?
对也不对。首先,这个逻辑是有合理性的。随着模型能力的提升,确实有很多 skill 被用户抛弃了,这些 skill 集中于 Superpower 之类所谓的「通用」skill。这些 skill 的定位,就是对一些模型能力缺陷的补齐,尤其是在各个模型没有疯狂地对 coding 进行针对性优化的时期,是有一些作用的。而随着模型本身能力的提升,这些东西其实慢慢都已经被模型吸收了,自然就没有了作用。
那 skill 是真的就没用了吗?恐怕也并非如此。接下来,我们会论述一下随着模型智能水平的提升,skill 还有什么作用。然后,会论述一下本文的主角:Flint。我会讲一下为什么要开发这个项目,以及它有什么作用。
什么是 skill(技能)
最近一段时间 AI 技术的蓬勃发展,看着技术一轮一轮的迭代,但实质上只是软件工程理论的再一次落地。
其中,skill 这一层,目标是实现「可复用性」,对应的是软件开发中的各种工具包。
而模型对应的是软件开发语言这一层。
复用程度的不同决定了一个功能是应该在语言层还是在工具包里。
比如,数组或者 map,就应该在语言里封装好,而不是你得引个第三方包才能用。而比如一个解析发票的逻辑,那么落到语言层里,就不合适了。
对应到 AI 当前的发展,skill 的定位就应该是这样的功能:有一定复用性,但复用性又不高、AI 没有足够的语料自主学会这个。
比如,公司内封装的工具包的使用方式,尤其是一些可能已经被淘汰掉的古早技术栈,模型拿不到足够的语料获取相关知识,相关知识只存在于相关开发人员的脑子里,这时候,就适合封装一批 skill 出来,成为团队固化的知识;
比如,你自己将自己的工作流固化出来的一些流程,比如我会用 Notion 管理工作任务,然后基于这个生成周报,那就可以封装成一个 skill 给 AI 使用;
再比如,我包了一个访问我带着真实 cookie 浏览器的 skill,在访问一些反爬比较强的网站时,就可以用这个 skill。就像这种 skill,包一个很简单,但如果想从网上下一个,却没那么容易。现在有些 agent 自己也会封装这样的能力,但用起来或多或少总会有一些不合心意。
所以,随着模型能力的提升,skill 并不会消失,但其起效果的范围会收敛到这些复用性不高不低的事上。不复用会很麻烦,但又不会有很普世的复用性。你下载下来别人的 skill,会发现不好用。
这也是我开发 Flint 这个项目的初衷,就是:把 skill 像个人资产一样管理。
Flint 是什么
Flint 是我开发的一个本地优先的个人 AI Skills 资产管理器。一句话概括:把你散落在各个 Agent、各个项目里的 skill 集中管起来——统一打标签、搜索筛选、同名去重,再按需投放到每个 Agent 和项目自己的技能目录里。它由一个本地后端和一个 Web 前端组成,一条脚本就能启动;你的技能仓库对应磁盘上一个普通目录,各 Agent 的技能目录通过软链或复制从这个源头分发。从此技能只有一份本体,放在你自己的地盘上,用到哪投到哪。
界面上 Flint 分成六个模块,各管一件事:
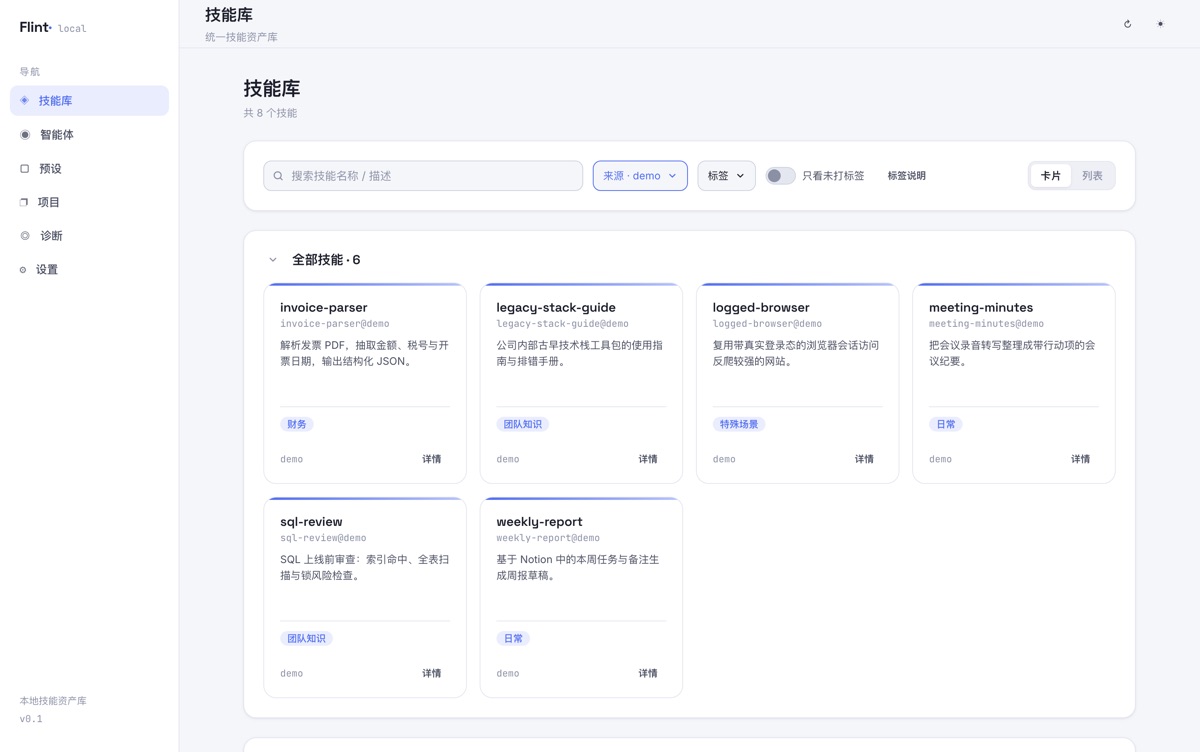
- 技能库:浏览、搜索、过滤你所有的 skill,预览
SKILL.md原文、编辑标签、追溯每个技能的来源;也可以在这里登记自有仓库和第三方只读仓库,把散在各 Agent 里的技能归集回仓库,或从任意目录批量导入。 - 智能体:每个实际的技能目录一张卡片。在这里把某个 Agent 设为活跃、关联预设、逐个开关技能,甚至按单个技能切换软链还是复制。
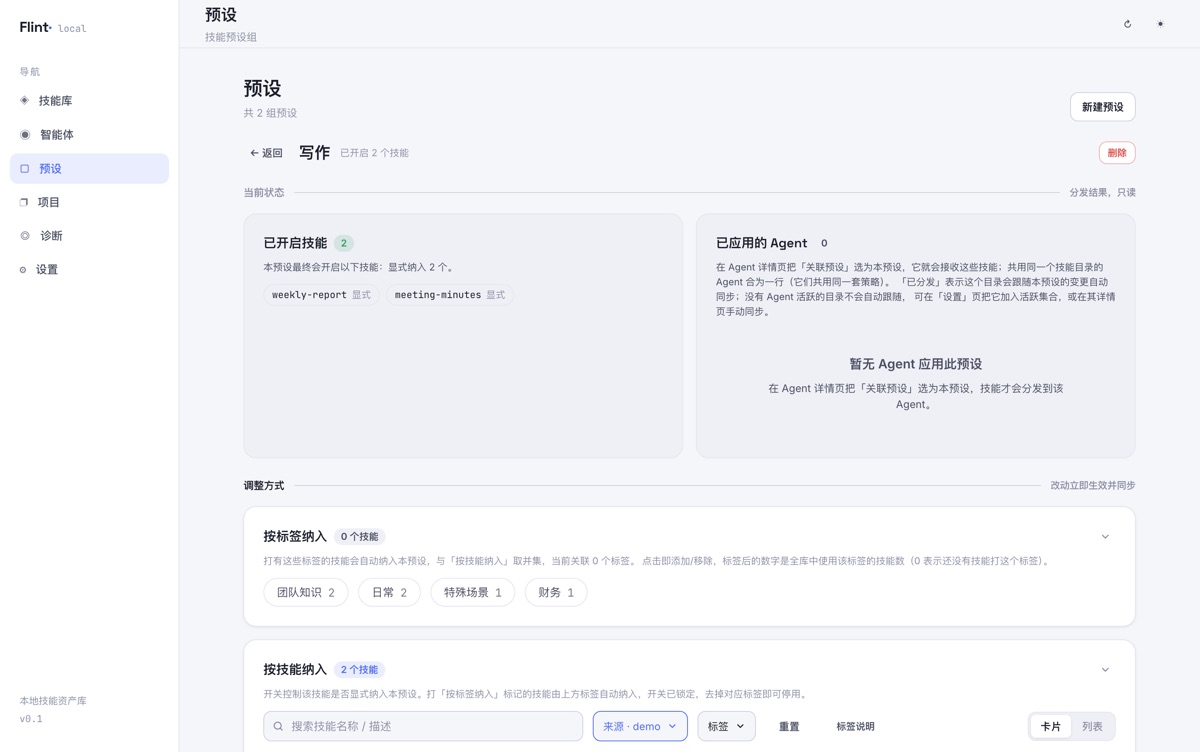
- 预设:一组 skill 套餐——显式成员加上关联标签命中的技能。预设没有开关,成员或标签一变,立刻分发到关联了它的活跃 Agent。
- 项目:登记项目路径和标签,匹配的 skill 自动进入项目的
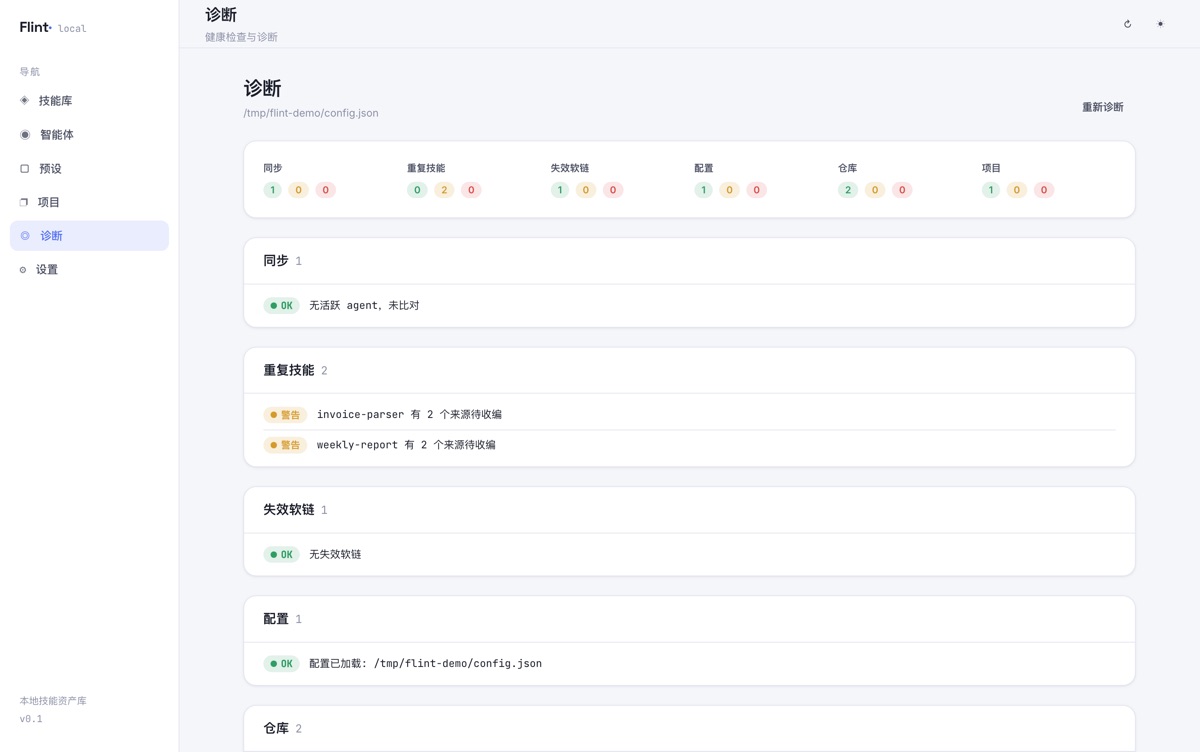
.agents/skills目录(可以提交进 git,跨机器自包含);项目里改出来的技能还能回写仓库。 - 诊断:六个维度的体检——同步、重复、失效软链、配置、仓库、项目,问题集中列出来,确认后一键修复。
- 设置:默认安装方式(软链 / 复制)、复制模式的增量同步 watcher、自定义 Agent、日志查看。
前四个模块串起来就是「收拢 → 整理 → 投放」的主路径,诊断和设置是兜底:出了状况去诊断页看问题出在哪,投放的默认姿势在设置里定。
下面两张界面截图可以建立点直观印象(均为演示数据)。技能库页:所有技能集中在一处,卡片上直接看描述和标签,顶栏按来源、标签筛选:
诊断页:六个维度的体检结果一屏列清。截图里「重复技能」的两条警告,正是同一个技能在自有仓库和第三方来源各存了一份,等着被收编成一份:
为什么需要它
除了上文说过的部分,还有一个现实因素,让我更需要对 skill 进行精细化的管理。
就是我需要经常性地切换不同的 agent。现在赛博菩萨很多,今天 WorkBuddy 放个免费模型,明天 TraeWork 发一批免费积分,千问、小米,这些也都不甘落后。这些免费的 token,不用白不用。但在经常切换 agent 的情况下,skill 的管理就成问题了。
今天我可能在 WorkBuddy 里实现了写日报的 skill,明天打开 TraeWork,发现用不了。
现在固然有 npx 等各种工具管理 skill,但我试了一下,都不太趁手。现在市面上的绝大多数 skill 管理工具,核心思路还是基于分享与分发,目标是建设一个大而全的 skill 仓库,然后安装到用户自己的各个 agent 里。
这样会带来几个非常显著的问题。
就是我们前边说的复用性问题。别人的 skill,下载下来通常运转得不会特别好,相信大家对于这一点或多或少都应该有些感受。而另一方面,让我们回到文章一开头,如果一个 skill 真的复用性非常好,开箱即用,那它大概率会被吸收进模型本身,反而没有必要作为一个 skill 存在。
切换 agent 的成本问题。npx 能一次性把 skill 安装到各个现存的 agent 里,但一旦使用新 agent,这个操作就很麻烦了。另一个重大问题是自己的 skill,无法纳入到 npx 等工具的管理中,会给切换 agent 带来巨大负担。
skill 使用的成本问题。比如一个公司内的 skill 集,可能有一两百个 skill,里边前端、后端、设计、运营各种 skill 都有,你可能只能用到其中一小部分,但如果没有精细化的管理手段,就只能把所有 skill 都安装进来了。这样,几乎所有主流 agent 都会把每个已安装技能的名称和描述注入系统提示词,供模型自行判断要不要调用。按每条描述 50~100 token 估算,200 个 skill 就是每次对话 1 万~2 万 token 的固定开销,再乘上 agent 一次任务的几十个来回,账单相当可观。而且开销还在其次,更麻烦的是检索效率:候选列表越长、无关条目越多,模型选错技能或干脆漏选的概率就越高,就像在塞满了别人工具的工具箱里找自己那把扳手。
基于上述原因,我开发了 Flint 这个项目。为什么用这个名字,灵感来自于 Obsidian。
Obsidian 在官网上用三句话概括过自己的理念:Sharpen your thinking(磨砺你的思考)、Your thoughts are yours(你的想法属于你自己——笔记私密地存在你的设备上,别人读不到,连官方也读不到)、Your knowledge should last(你的知识应当长存——使用开放文件格式,你永远不被锁死,长期拥有自己的数据)。
Flint 沿用了同一套「以石喻工具」的命名脉络:黑曜石(Obsidian)是天然锋利的火山玻璃,远古人类把它打制成刀刃;燧石(Flint)是与黑曜石并肩的另一块「工具之石」,只是把打磨的对象从「知识」换成了「技能」。燧石的两层特性,正好对应这个项目的两个动作——打制(knapping):把散落的 skill 收拢、去重、打标签,敲成精确趁手的工具;取火(spark):把技能投放、分发到各个 Agent 与项目目录,让它们真正被点燃、开始干活。
你收藏的每一项技能,都是等待被击出火花的一块燧石。
核心理念:像 Obsidian 管理知识一样管理技能
正是沿着和 Obsidian 一脉相承的思路,Flint 把那三条理念逐条搬到了技能管理上:
| Obsidian 的理念 | Flint 的对应 |
|---|---|
| 本地即私有 | 技能只以普通文件存在你的本地磁盘,无云端、无账号、无上报 |
| 开放格式、永不锁定 | skill 本体就是磁盘上的 SKILL.md 目录,随时可打开、编辑、diff、用 git 提交;换工具、换生态,这份资产照常带走、照常使用,不被 Flint 绑定 |
| 磨砺你的思考 | 收拢、去重、打标签,再一键投放到需要它的 Agent 与项目里,让个人技能库越攒越趁手 |
落到具体设计上,还有两个值得一提的取向。其一,元数据尽量贴合开源生态共识:标签优先写在每个 SKILL.md frontmatter 的顶层 tags 字段上——这个位置能被 Claude Code、agentskills.io 等 40+ 工具原生读取,并随技能目录一起被 git 版本化,而不是存进某个私有数据库。其二,尽量降低生态碎片化:同名技能多来源时自动去重、只保留一份,重复、分歧、失效引用都集中到诊断页看清并就地处理,避免同一份 skill 在你的环境里以多个副本反复膨胀。
最小通路:四条步骤跑通
Flint 是个跑在本机的小工具(Node.js ≥ 20),用法文档写得比较全,这里只把第一次使用的四条必要步骤捋一遍:
- 安装:仓库根目录执行
./start.sh,脚本会自动检查 Node 版本、依赖与端口占用,首次运行自动npm install,装完打开浏览器即可(前端localhost:5173,后端 APIlocalhost:8787)。 - 登记仓库:仓库是 skill 的集合与事实源,对应磁盘上一个目录。自有仓库正常维护;第三方仓库作为只读来源登记,里面的技能随时可以被自有仓库「导入」收用。
- 新建预设:一个预设就是一份 skill 套餐——显式成员并上关联标签命中的技能。
- 把预设应用到 Agent:在某个 Agent 的详情页先把它「设为活跃」,再关联刚建的预设。此后预设的成员或关联标签一变,已关联它的活跃 Agent 会立刻拿到这套 skill。
至此,「登记仓库 → 配预设 → 投给 Agent」的最小通路就打通了,你的技能已经可以跨 Agent 工作。再往后的归集、接管、项目专属技能、六维诊断,都是锦上添花。
预设详情页长这样(演示数据):上半部分是当前状态——这个预设最终会开启哪些技能、已经应用到了哪些 Agent;下半部分是两种调整方式,「按标签纳入」和「按技能纳入」取并集,改动立即生效:
小结
以上就是我对于未来 skill 变化趋势的理解,和开发 Flint 的缘由。如果大家认可这个思路,欢迎来试用产品并提出建议。
项目已经开源,仓库在 GitHub: lcy362/flint,clone 下来执行 ./start.sh 就能跑起来体验;README.md 里有完整的使用指引,docs/ 下还有产品需求(PRD)和技术架构两份文档,欢迎试用后提 issue 交流。
 微信