数据分析的利器-clickhouse介绍
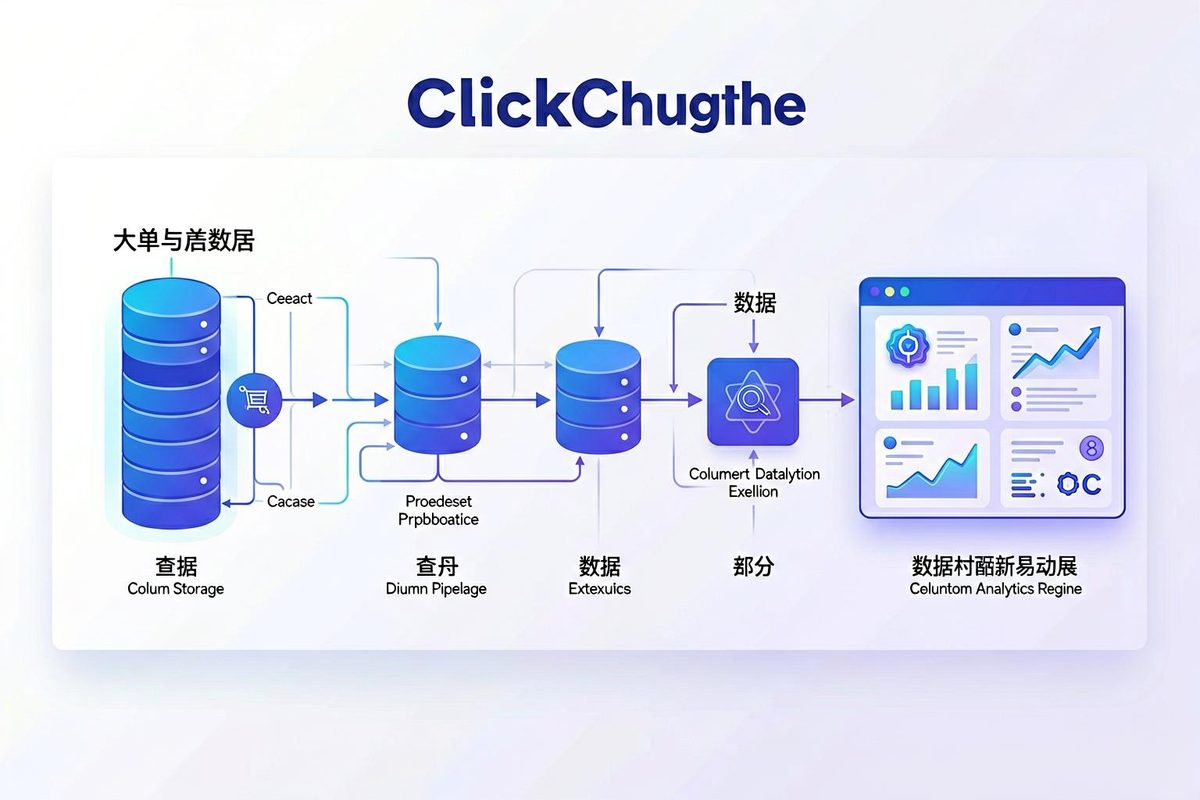
Clickhouse是Yandex开源的一个用于实时数据分析的数据库,一开始就用在yandex内部的多个数据分析业务上。要介绍clickhouse,还是需要先介绍一下yandex。Clickhouse为什么会出现,其实和yandex的业务关系非常大。Yandex是俄罗斯最大的搜索引擎,会有很多数据分析的业务,其中数据量最大的业务,就是Yandex.Metrica,这是一个和百度统计类似的网站数据分析服务,数据量也仅次于google analysis。自从Clickhouse开源后,在国内外的很多公司的线上业务都已经开始使用。 因此,写这篇clickhouse教程,对clickhouse做一个基础的介绍。 概述Clickhouse是极其适合OLAP(联机分析处理)问题的一个数据库。这类问题有如下一些特点: 请求以读为主,数据添加、更新一般以批量的形式进行; 表可以很宽,但是实际查询时只会用到有限的几列; 列值较小,一般是数字或者短字符串; 查询结果集的大小显著小于源数据; 事务处理需求较弱 根据clickhouse提供的性能测试结果,clickhouse的性能要大大领先于所...
通过位运算转换大小写
位运算是计算机科学中最基础也最高效的操作之一。今天介绍一个经典的位运算应用:用一行代码完成英文字母的大小写转换。 为什么需要位运算做大小写转换?你可能第一反应是:Java 不是有 Character.toUpperCase() 和 Character.toLowerCase() 吗?为什么要自己写? 确实,99% 的场景下你应该用标准库。但了解这个技巧有几个价值: 面试中的常见考点:很多算法面试会考察这种位运算思维 理解计算机底层:知道 ASCII 码的设计精妙之处 嵌入式/底层开发:在没有标准库的环境下,这就是实际操作 代码简洁:ch ^= 32 比 Character.isUpperCase(ch) ? Character.toLowerCase(ch) : ch 优雅得多 ASCII 码的巧妙设计要理解这个技巧,先看英文字母在 ASCII 表中的编码: 字母 十进制 十六进制 二进制 A 65 0x41 0100 0001 a 97 0x61 0110 0001 B 66 0x42 0100 0010 b 98 0x62 0110 ...
activemq多线程消费的不同处理方式
问题场景之前在另一篇文章里介绍过使用activemq时,client端的基本语法。 值得注意的是消费者, 12345678910111213141516171819202122232425262728293031323334353637383940414243444546474849 public void consume() throws JMSException { ActiveMQConnectionFactory cf = new ActiveMQConnectionFactory(); cf.setBrokerURL("tcp://localhost:61616"); Connection connection = cf.createConnection(); connection.start(); Session session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); ...
高并发下作余额扣减的一些经验
前一段时间参加了优化一个老的计费系统,学习了一些高并发下做余额扣减的常用手段,也做了一些尝试,因此在这里总结记录一下, 在高并发下对。 问题描述对于一个计费系统来说,并发问题事实上分为两类,一类是应用并发高,也就是纯粹的用户量大,访问量多,这类问题和一般的高并发问题没有区别,用分布式等手段就可以解决;另外一类问题则是一般分布式手段无法解决的用户高并发问题,也是本文要着重说的。这类问题源自对某些高频账号,大量的并发访问,会导致瓶颈首先出现在某些数据库记录上,大量操作由于无法竞争到数据库的行锁而导致等待,这些等待中的操作又会占用其他资源,最终导致系统不可用。针对这类问题,下边介绍一些常用的处理办法。 不设置余额字段由于对于一个稳定的计费来说,一定是会记录计费流水明细的,所以完全可以不设置余额字段,而采用根据流水明细计算的方式来获取余额。不过这种方法不是万能的,比如拿广告业务的计费系统来说,频率非常高,而每次的金额很小,这时候想通过计算求和去算余额,显然是不现实的。 合并与拆分这是两种方式,因为有一些相似之处,都是要降低对单条数据库记录的访问压力,所以也就放到一起说了。合并,就是对...
java细节:三目运算符和自动拆箱
问题引入今天用findbugs扫代码时遇到一个很有意思的问题,有关三目运算符的,在这儿记录一下。 就是类似这么一行代码: 12boolean b = true; Long a = b ? 0l : Long.valueOf(2); Findbugs给出了”Boxed value is unboxed and then immediately reboxed”的提示,意思就是有装箱的对象做了拆箱,然后又马上做了装箱。这个问题其实很常见,一开始也没注意,只是习惯性的把Long.valueOf 改成了Long.parseLong, 确实把这个警告消掉了,不过之后才意识到不对:明明valueOf返回的是Long类型,parseLong返回的是long类型,而需要的正是Long类型,为什么反而用valueOf的时候有问题呢。 其实思考一下大概也能想明白,主要就在三元运算符的另一个分支,因为另一个分支返回的是一个未装箱的0,所以这个三元运算符的返回值就成了long,所以原本的Long类型就要经过一次拆箱才会被返回。要优化这个部分的话,保持两个分支的返回类型一致就可以了。 然后把相...
设计一个开源的北京地铁路线规划小工具 java版本
概述最近在找房子,因为想找一个去几个地方都相对方便的位置,自己去地图上看还挺麻烦的,所以想做个小工具,用来对北京地铁的路线做规划,本文就简单介绍一下实现过程。目前的功能还比较简单,主体方法就是根据一个输入的始发站,列出其他所有站点到这个地方的站数最少路线。 数据获取从网上找了高德地图的接口数据: http://map.amap.com/service/subway?_1469083453978&srhdata=1100_drw_beijing.json . 对拿到的json串进行解析,其中包含每条地铁线路的信息,并依次列出线路上的每个站点。 通过解析数据,要得到的主要就是各个站点的信息,站点定义的数据结构如下: 123456private String id;private String name;private Set<String> lines = new HashSet<String>(); //所在线路private String position;private String pinyin;private Set<String&...
redis cluster的数据迁移
在之前的一篇文章通过实际操作理解redis cluster原理中,我们简单介绍过redis cluster的设计原理。redis cluster中的数据是根据一定规则分配到16384个slot中,这些slot又根据配置对应到不同的节点上。我们知道,在集群稳定运行后,仍然可以以slot为单位转移数据,不过对于具体的转移过程,包括转移过程中集群的可用性等问题,一直不是太确定,所以这次详细了解了一下。 整体流程redis官方文档中提供的数据迁移办法是借助redis-trib脚本,其实严格来说,这个redis-trib并不是redis本体的一部分,它只是官方按照redis设计规范实现的一套脚本集合,帮助用户更方便的使用redis-cluster。 实际上,我们完全可以脱离这个脚本来使用cluster, 或者用其他方式实现这套逻辑,比如搜狐tv的redis运维工具cachecloud里,就用java实现了整套逻辑。 我们可以参考redis-trip或者cachecloud的代码来了解cluster数据迁移的流程,主要分为如下几部: 设定迁移中的节点状态,比如要把slot x的数据从节...
jstorm源码解析之循环任务AsyncLoopThread
概述AsyncLoopThread是jstorm里自定义的一个循环执行任务的工具,实现不复杂,本来是不值当的专门开一篇文章介绍。不过这个在jstorm里应用实在太广泛了,诸如uspervisor/nimbus心跳,获取新topology,更新worker状态等大量功能都是利用AsyncLoopThread实现的,所以还是介绍一下吧,也方便后续看其他部分代码。 使用AsyncLoopThread其实完全可以拿出来用在我们自己的工程里,使用比较方便,可以参考 https://github.com/lcy362/Scenes/blob/4d8ec4ff166060cf5d491c33a96f5c86e8389333/src/main/java/com/mallow/jstormcode/AsyncLoop.java 只需要先定义一个RunnableCallback类,RunnableCallback是jstorm里封装的一个线程类,对Runable接口做了一些增强,可以回调,可以主动关闭。 123456789101112public class TestThread ex...

activemq特性之持久化
介绍数据的持久化是很多系统都会涉及到的一个问题,尤其是redis,activemq这些数据主要是存储在内存中的。既然存在内存中,就会面临宕机时数据丢失的风险。这一问题的解决方案就是通过某种方式将数据落到磁盘上,也就是所谓的持久化。 activemq提供了三种持久化方式,分别基于jdbc, kahadb和leveldb. 目前官方最推荐的是基于kahadb的持久化。 jdbc是activemq最早提供的一种持久化方式,但是用数据库去做持久化确实不合适,毕竟性能有瓶颈,而且只是需要简单的读写数据,不需要数据库各种强大的功能。现在去看文档的话,连基本的配置都被埋的很深,所以这种方式我们也就不细说了。 正是由于基于jdbc的方式存在的种种问题,activemq后来就接连提供了基于kahabd和leveldb的持久化方式.leveldb 是google开源的一个KV磁盘存储系统,应用很广,kahadb没找着源头,应该就是activemq团队开发的,也是一种基于磁盘的存储系统。按理说,leveldb的性能是要好一些的,之前无论是activemq的默认配置,还是文档里的推荐使用方法,都是首选l...
activemq的安装及基本使用
安装从官网下载最新版本,解压,其他的前期准备只需要安装jdk。 从activemq 5.14开始,只支持jdk8。 配置核心配置文件是conf目录下的activemq.xml, 默认的配置无需修改即可使用,其他配置我们会在后续文章介绍activemq各种特性时详细介绍。 启动bin目录下运行 activemq start 即可 ,启动之后浏览器打开localhost:8161 可以打开web管理页面。 基本api使用这里只介绍java下的api使用,activemq默认的openwire协议是只支持java的,因为实现的JMS协议是java下的协议。如果有其他语言的访问需求,可以用stomp,amqp等协议。 依赖包引入activemq官方的client包。 1234<dependency> <groupId>org.apache.activemq</groupId> <artifactId>activemq-client</artifactId></dependency> actibemq收发消息的主要步...