activemq的安装及基本使用
安装从官网下载最新版本,解压,其他的前期准备只需要安装jdk。 从activemq 5.14开始,只支持jdk8。 配置核心配置文件是conf目录下的activemq.xml, 默认的配置无需修改即可使用,其他配置我们会在后续文章介绍activemq各种特性时详细介绍。 启动bin目录下运行 activemq start 即可 ,启动之后浏览器打开localhost:8161 可以打开web管理页面。 基本api使用这里只介绍java下的api使用,activemq默认的openwire协议是只支持java的,因为实现的JMS协议是java下的协议。如果有其他语言的访问需求,可以用stomp,amqp等协议。 依赖包引入activemq官方的client包。 1234<dependency> <groupId>org.apache.activemq</groupId> <artifactId>activemq-client</artifactId></dependency> actibemq收发消息的主要步...
activemq系列-概述
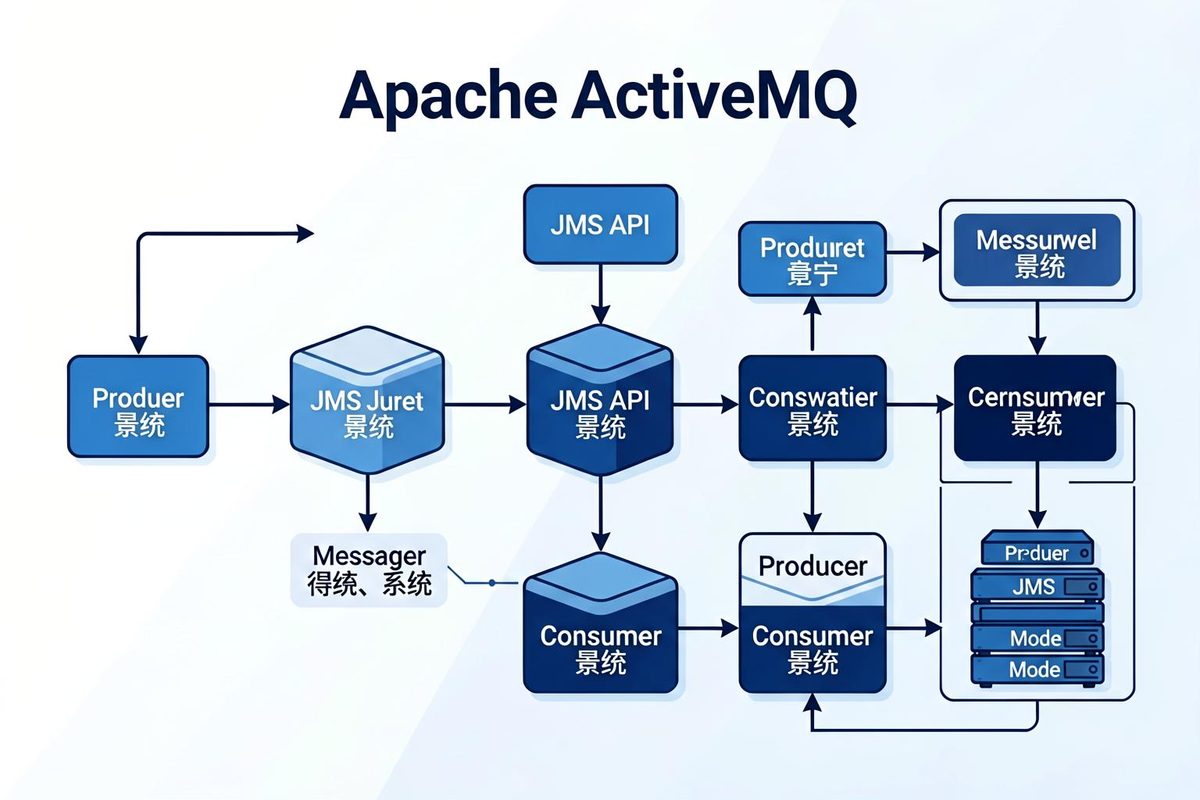
ActiveMQ 是 Apache 旗下的开源消息中间件(Message-Oriented Middleware,MOM),也是 JMS(Java Message Service)1.1 规范的完整实现。本文是 ActiveMQ 系列文章的开篇,先讲清楚消息中间件是什么、解决什么问题,再介绍 JMS 的核心概念,为后续深入学习 ActiveMQ 的具体特性打好基础。 消息中间件解决什么问题?消息中间件是分布式系统中非常常见的组件。它的核心定位是作为应用程序之间的中介——各个应用不直接互相通信,而是通过消息中间件来传递消息。 两个最核心的价值:解耦和削峰。 解耦想象一个用户登录的场景:登录成功后,可能会有多个下游系统需要响应——给用户发欢迎消息、更新推荐算法、同步用户数据到数据仓库、触发风控检查……这些操作跟登录本身没有直接关系,如果把逻辑全部写在登录模块里,不仅代码会变成一锅粥,登录的响应时间也会变得不可接受。 引入消息中间件后,登录模块只需要在验证成功后发一条”用户已登录”的消息,其他系统各自监听这个消息,独立执行自己的业务逻辑。登录模块不再需要知道下游有哪些系统,新增一个...
hexo教程:博客系统搭建及部署到github
原文地址: https://lichuanyang.top/posts/19890/ Hexo是一款开源的博客系统。对于一个后端程序员来说,不想折腾前端的东西,但是csdn,博客园之类的用起来还是不太方便,自己搭博客又麻烦,做出来还丑。偶然间看到了hexo,这个对后端程序员来说可以说是非常友好了。所以也写篇文章记录一下hexo安装,一些关键配置,以及部署到github的过程。 安装及初始化参考官方文档 就可以了。hexo是基于node.js的,用过node的自然没有任何问题,没用过也没关系,照着说明文档做就可以了。 hexo支持直接向github的page发布,只需要配置好自己的github信息就可以。 主题hexo有很多定制主题, 按个人喜好使用吧, 我用的是next , 这款主题功能非常多,统计、搜索之类的都是一条配置都搞定了。不过这款的一些基础配置和其他主题似乎是有些区别的,所以用了以后如果以后想换别的可能会有点困难。 内容迁移hexo提供了多个从其他博客迁移数据的插件,rss,blogger等等都可以。 以博客园为例,博客园的博客可以导出一个rss文件,然后我们用hexo...
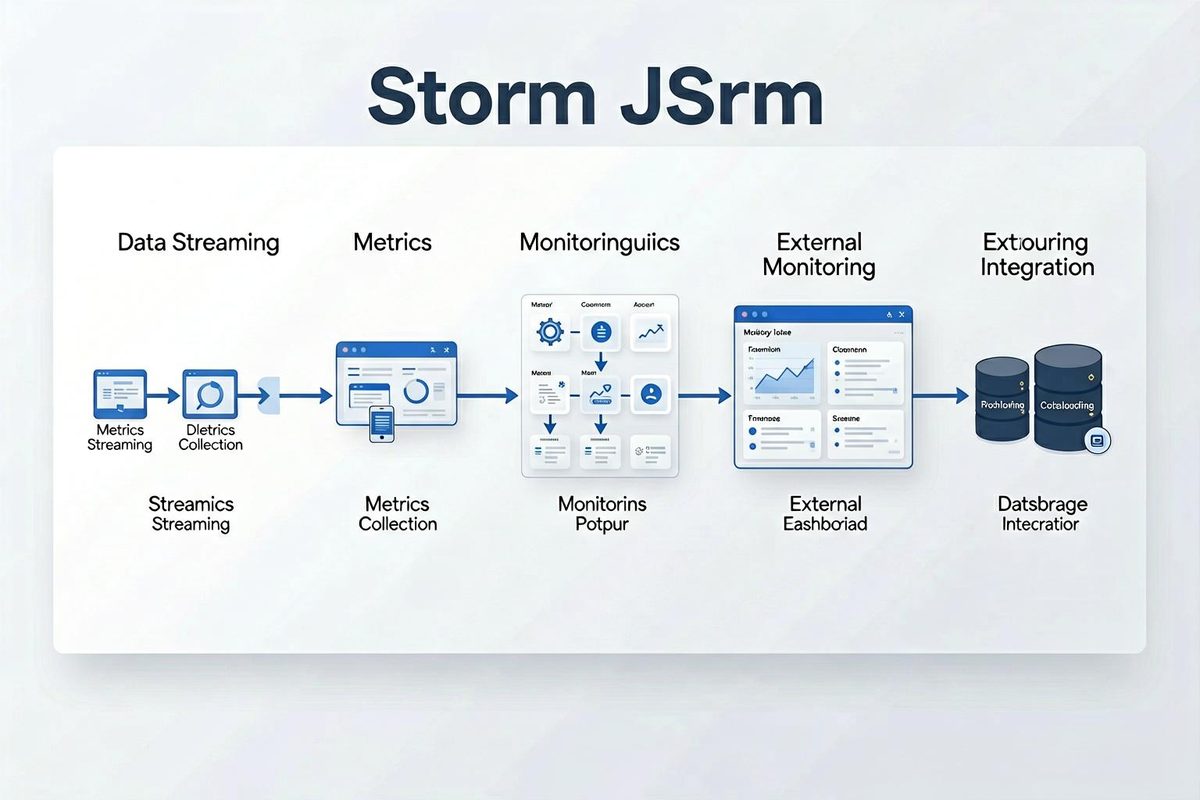
jstorm的监控metrics数据输出到第三方存储介质
JStorm Metrics 体系Jstorm的UI中提供了大量非常详细的监控参数,对于我们排查问题帮助非常大,关于UI,可以参考我之前的另一篇文章: https://lichuanyang.top/posts/31996/ 。 不过,UI这种方式用起来有时可能会不太方便,比如需要查历史数据的时候。所以我们希望将监控数据输出到别的存储介质中,方便后续查询、分析。 由于jstorm的监控相比于apache-storm进行了完全的重写,所以网上查到的storm的监控输出方式并不适用于jstorm. 而jstorm除了官方文档以外实在缺少资料,官方文档又太简略,给的只是一些线索性的东西,具体还要结合这些线索去翻阅源码。所以我整理了一个jstorm监控数据输出的例子。 自定义 Metrics 上报首先需要实现MetricUploader这个接口,不过其实我们并不会实际使用这个接口里的哪个方法,主要是要去用它的TopologyMetricsRunnable这个参数,然后用这个参数去取监控信息。所以理论上只要拿到TopologyMetricsRunnable就行,并不一定非要实现Metric...
camel系列之camel debugger的使用
Apache Camel 是一个强大的企业集成框架,基于 EIP(Enterprise Integration Patterns)实现了 200 多种组件,可以轻松连接各种数据源和中间件。但它的强大也带来一个问题:高度封装让底层细节变得不透明,一旦路由出问题,排查起来非常困难。 好在 Camel 官方提供了一个 Debugger 工具,可以像调试普通 Java 程序一样在路由节点上打断点、查看消息内容。本文在官方文档的基础上,补充一些实用的调试技巧。 为什么要用 Debugger?Camel 的路由定义通常非常声明式,比如: 1234from("file:inbox") .unmarshal().json() .bean(SomeTransformer.class) .to("activemq:queue:orders"); 看起来清晰简洁,但如果消息在某个环节被处理错了,你怎么知道是 unmarshal 出了问题还是 SomeTransformer 的 bug?这个时候 Debugger 就派上用场了。 快速上手1...
jstorm源码解析之bolt异常处理
问题用过storm或者jstorm的都知道,如果在bolt代码中发生了没被catch住的异常,所在worker进程会退出。本文就从源码角度分析一下具体设计,其实并不是“有异常然后进程崩了”这么简单。 实质我们先看BasicBoltExecutor的源码: 123456789101112public void execute(Tuple input) { _collector.setContext(input); try { _bolt.execute(input, _collector); _collector.getOutputter().ack(input); } catch (FailedException e) { if (e instanceof ReportedFailedException) { _collector.reportError(e); } _collector.getOutputt...
log4j动态添加appender
大多数 Java 开发者习惯通过配置文件(log4j.properties 或 log4j.xml)来管理日志输出。但在某些运维场景下,运行时动态修改日志配置会更加灵活——比如线上排查问题时临时开 DEBUG 级别,或者动态将日志推送到 Kafka 做集中分析。 Log4j 1.x 的 API 完全支持运行时代码修改配置。本文以 KafkaAppender 为例,演示如何动态添加 appender。 静态配置 vs 动态配置 方式 适用场景 优缺点 配置文件(静态) 日常开发、常规部署 简单、标准化;但修改需要重启 API 编程(动态) 线上排查、运维自动化 灵活,不需要重启;但需要对 API 熟悉 基本示例:动态添加 KafkaAppender123456789101112131415161718192021222324import org.apache.log4j.Logger;import org.apache.log4j.PatternLayout;import org.apache.log4j.Level;import org.apache.log...
【翻译】java里编写基准测试的一些经验
为什么需要基准测试有时候我们需要写一些简单的性能测试代码,恰好在stackoverflow上看到一篇经验之谈,https://stackoverflow.com/questions/504103/how-do-i-write-a-correct-micro-benchmark-in-java, 怎样写基准测试来尽量屏蔽掉环境的影响。 翻译出来贴在这儿: 编写可靠的基准测试来自Java HotSpot作者的撰写微基准的提示: 规则0:阅读有关JVM和微型基准测试的好论文。比如https://www.ibm.com/developerworks/java/library/j-jtp02225/。不要对这种测试有太高的期望;它们对JVM性能的测试仅能起到有限效果。 规则1:始终包含一个预热阶段,它一直运行,直到触发所有的初始化和编译。 (预热阶段的迭代次数可以减少,经验法则是几万次循环。) 规则2:始终使用-XX:+PrintCompilation -verbose:gc 等参数来运行,这样可以确定编译阶段和JVM的其他部分在计时时是否进行了一些意外的工作。 规则2.1:在计时和预热阶...

java线程池:获取运行线程数并控制线程启动速度
Java 的线程池用起来很方便——Executors.newFixedThreadPool(n) 一行代码搞定。但如果任务提交速度远快于执行速度,任务会在无界队列中无限堆积,最终导致 OOM。今天分享一个真实案例和几种解决方案。 问题场景假设你有一个批量处理任务:遍历一个目录下的 100 万个文件,每个文件提交一个任务去处理。每个任务需要加载一些数据到内存。 123456789ExecutorService executor = Executors.newFixedThreadPool(10);for (File file : files) { executor.submit(() -> { // 这个任务占用大量内存 byte[] data = loadFileContent(file); process(data); });} 问题在于:Executors.newFixedThreadPool 使用的是无界队列(LinkedBlockingQueue),任务提交速度远大于...
maven里的mirror和repository: 配置多repository
maven里的mirror和repository是两个比较容易混淆的概念,它们的作用都是配置远程maven仓库的地址。顾名思义,repository就是直接配置站点地址,mirror则是作为站点的镜像,代理某个或某几个站点的请求,实现对repository的完全代替。 repository有两种形式可以配置多个repository, 配置多个profile或者在同一个profile中配置多个repository.配置多profile时,还需要配置activeProfiles使配置生效。 配置示例: 1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253545556575859606162636465666768697071727374 <profiles></profile> <profile> <id>central</id> <repositories> ...
公告